Ищите архивную копию сайта?
Архив интернет (Web archive) — это бесплатный сервис по поиску архивных копий сайтов. С помощью данного сервиса вы можете проверить внешний вид и содержимое страницы в сети интернет на определенную дату.
Информацию из Вебархива вы можете использовать в ознакомительных целях, либо для доказывания определенных обстоятельств в суде. В данном случае рекомендуем вам надлежащим образом зафиксировать или нотариально заверить найденную архивную копию страницы сайта.
- Заверить сайт
- Заверить видео
- Заверить переписку
- Заверить социальные сети
Как посмотреть на сайт в прошлом: инструмент + способ восстановления

Сервис, который может показать, как выглядели сайты в прошлом, напоминает своеобразную машину времени в интернете. С его помощью можно перенестись на год, два или двадцать лет назад и увидеть, какими ресурсы были тогда. Зачем может понадобиться эта информация и как воспользоваться данным сервисом?
- 1 Для чего нужно искать старые версии сайтов
- 2 Как узнать прошлое веб-ресурса с помощью archive.org
- 2.1 Если это страница Вконтакте
- 3.1 Поисковик Яндекс
- 3.2 Поисковик Google
- 3.3 YouTube
- 3.4 Википедия
- 3.5 ВКонтакте
Для чего нужно искать старые версии сайтов
Причины, по которым может быть необходимо посмотреть сайт в прошлом времени, могут быть абсолютно разными. Часто это желание погрузиться в приятную ностальгию. Например, посмотреть, как раньше выглядели популярные площадки и соцсети. Или же посмотреть, как выглядел собственный сайт несколько лет назад. К счастью, существует инструмент, который позволяет это сделать, даже если сам ресурс уже давно не доступен.
Как это возможно? Если сайт существует в интернете хотя бы пару дней, он попадает в веб-архив. Инструмент сохраняет его код, благодаря чему, можно увидеть, как он выглядел даже много лет назад.
Причины, по которым возникает необходимость посмотреть порталы в прошлом времени:
- Отслеживание истории изменений. Такая потребность может возникать у копирайтеров или журналистов для подготовки нового контента. Также это может быть нужно для анализа конкурентов: можно проследить путь их развития и увидеть допущенные ошибки.
- Восстановление ресурса. Если пользователь забыл продлить домен или не сделал бэкап, веб-архив будет отличным вариантом восстановления.
- Поиск уникального контента. Если площадка больше не доступна, её контент становится уникальным. Можно использовать его полностью или частично, предварительно проверив уникальность.
- Увидеть необходимый контент, если страница уже недоступна. Например, пользователь добавил площадку в закладки, а через время оказалось, что её больше нет. Тогда посмотреть её содержимое можно только с помощью веб-архива.
Как узнать прошлое веб-ресурса с помощью archive.org
Чтобы узнать, как выглядел конкретный веб-ресурс ранее, можно воспользоваться сайтом для просмотра страниц в прошлом – a rchive.org. Для этого нужно выполнить следующее:
- Пройти по ссылке https://archive.org/.
- Ввести URL-адрес и нажать кнопку «Go».

- Выбрать интересующий период времени. Затем с помощью календаря найти нужную дату, навести на нее курсор мыши и выбрать время сохранения копии (в списке может быть как одна, так и несколько ссылок).

После этого откроется главная страница в том виде, какой она была в выбранный период.

Учитывайте, что кликабельными в календаре являются только дни, помеченные синим или зеленым цветом. Посмотреть, как выглядел сайт в даты без подсветки, не получится.
Если это страница Вконтакте
Аналогичным образом можно узнать содержимое страницы ВКонтакте. Достаточно указать на нее ссылку в соответствующем поле.
По сравнению с новостными или другими веб-ресурсами здесь будет меньше подсвеченных дат с сохранённым содержимым. Количество дат зависит от популярности страницы: у обычных пользователей их будет немного, в то время как у известных медиа-личностей – на порядок больше.

Дальнейшие действия такие же: надо выбрать любую из подсвеченных дат и перейти по кликабельной ссылке. В этой же вкладке откроется страница в ВКонтакте с актуальным на тот момент содержимым.
Как выглядели культовые сайты раньше
Для примера посмотрим, как выглядели популярные ресурсы раньше, а именно Яндекс, Google, YouTube, Википедия и VK. Все из них с течением времени претерпели кардинальные изменения в дизайне.
Поисковик Яндекс
Поисковую систему Яндекс официально анонсировали 23 сентября 1997 года. С тех прошло более 20 лет, и сегодня это одна из самых популярных поисковых систем в мире.
В веб-архиве первая сохраненная копия датируется 6 декабря 1998 года.

На тот момент выглядел Яндекс вот так:

Поисковик Google
Поисковая система Google была основа чуть позже – в 1998 году. Сейчас это самая популярная поисковая система в мире.
Первые сохраненные копии появились в веб-архиве в конце 1998 года. Например, 2 декабря Гугл выглядел вот так:

YouTube
Youtube начал свою работу в феврале 2005 года. Первые сохраненные в веб-архиве копии появились в конце апреля 2005 года. На то время сервис имел минималистичный дизайн, и видно, что он являлся не более, чем видеохостингом:

Википедия
Википедия появилась 15 января 2001 года. Сегодня она является наиболее крупным и популярным справочником в интернете и содержит более 40 миллионов статей, которые доступны на 301 языке.
В веб-архиве первая сохраненная копия Википедии датируется 27 июля 2001 года:

ВКонтакте
Популярная в России и других странах социальная сеть ВКонтакте была создана 10 октября 2006 года.
В веб-архиве первая сохраненная копия сайта датируется 8 ноября 2006 года. На нём видно, что сайт изначально был ориентирован на студентов и выпускников.

Можно ли восстановить сайт из вебархива?
При потере данных, восстановить свой сайт можно с помощью сайта https://webarchiveorg.ru/. Для этого нужно:
- ввести URL-адрес;
- выбрать нужный год, месяц и число;
- нажать кнопку «Восстановить сайт».

Услуга является платной, поэтому перед восстановлением рекомендуется ознакомиться с тарифами. Точная стоимость зависит от количества сайтов и его страниц.
Выводы
С помощью веб-архива можно посмотреть, какой дизайн и контент были у сайтов раньше, что может быть необходимо для восстановления данных, анализа конкурентов, поиска интересного контента с исчезнувших ресурсов или просто ради интереса.
HackWare.ru
Этичный хакинг и тестирование на проникновение, информационная безопасность
Веб-архивы Интернета: как искать удалённую информацию и восстанавливать сайты
Что такое Wayback Machine и Архивы Интернета
В этой статье мы рассмотрим Веб Архивы сайтов или Интернет архивы: как искать удалённую с сайтов информацию, как скачать больше несуществующие сайты и другие примеры и случаи использования.
Принцип работы всех Интернет Архивов схожий: кто-то (любой пользователь) указывает страницу для сохранения. Интернет Архив скачивает её, в том числе текст, изображения и стили оформления, а затем сохраняет. По запросу сохранённые страницу могут быть просмотрены из Интернет Архива, при этом не имеет значения, если исходная страница изменилась или сайт в данный момент недоступен или вовсе перестал существовать.
Многие Интернет Архивы хранят несколько версий одной и той же страницы, делая её снимок в разное время. Благодаря этому можно проследить историю изменения сайта или веб-страницы в течение всех лет существования.
В этой статье будет показано, как находить удалённую или изменённую информацию, как использовать Интернет Архивы для восстановления сайтов, отдельных страниц или файлов, а также некоторые другие случае использования.
Wayback Machine — это название одного из популярного веб архива сайтов. Иногда Wayback Machine используется как синоним «Интернет Архив».
Какие существуют веб-архивы Интернета
Я знаю о трёх архивах веб-сайтов (если вы знаете больше, то пишите их в комментариях):
- https://web.archive.org/
- http://archive.md/ (также использует домены http://archive.ph/ и http://archive.today/)
- http://web-arhive.ru/
web.archive.org
Этот сервис веб архива ещё известен как Wayback Machine. Имеет разные дополнительные функции, чаще всего используется инструментами по восстановлению сайтов и информации.
Для сохранения страницы в архив перейдите по адресу https://archive.org/web/ введите адрес интересующей вас страницы и нажмите кнопку «SAVE PAGE».

Для просмотра доступных сохранённых версий веб-страницы, перейдите по адресу https://archive.org/web/, введите адрес интересующей вас страницы или домен веб-сайта и нажмите «BROWSE HISTORY»:
В самом верху написано, сколько всего снимком страницы сделано, дата первого и последнего снимка.
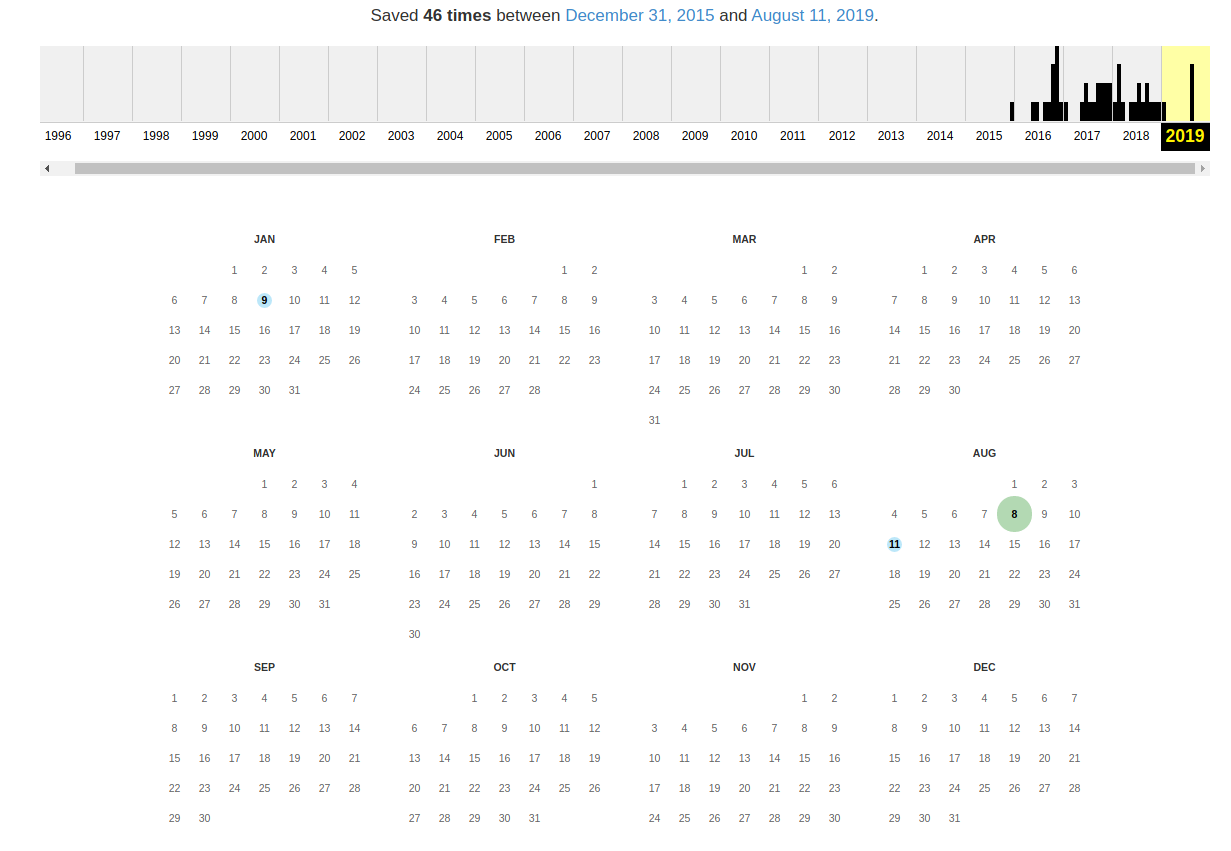
Затем идёт шкала времени на которой можно выбрать интересующий год, при выборе года, будет обновляться календарь.
Обратите внимание, что календарь показывает не количество изменений на сайте, а количество раз, когда был сделан архив страницы.
Точки на календаре означают разные события, разные цвета несут разный смысл о веб захвате. Голубой означает, что при архивации страницы от веб-сервера был получен код ответа 2nn (всё хорошо); зелёный означает, что архиватор получил статус 3nn (перенаправление); оранжевый означает, что получен статус 4nn (ошибка на стороне клиента, например, страница не найдена), а красный означает, что при архивации получена ошибка 5nn (проблемы на сервере). Вероятно, чаще всего вас должны интересовать голубые и зелёные точки и ссылки.
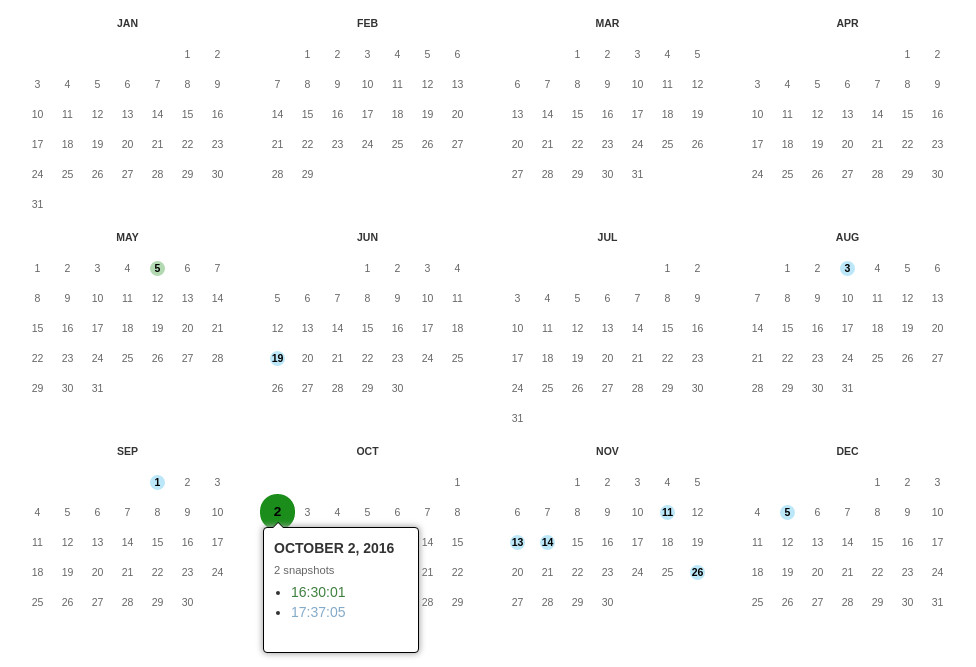
При клике на выбранное время, будет открыта ссылка, например, http://web.archive.org/web/20160803222240/https://hackware.ru/ и вам будет показано, как выглядела страница в то время:

Используя эту миниатюру вы сможете переходить к следующему снимку страницы, либо перепрыгнуть к нужной дате:
Лучший способ увидеть все файлы, которые были архивированы для определённого сайта, это открыть ссылку вида http://web.archive.org/*/www.yoursite.com/*, например, http://web.archive.org/*/hackware.ru/
Кроме календаря доступна следующие страницы:
- Collections — коллекции. Доступны как дополнительные функции для зарегистрированных пользователей и по подписке
- Changes
- Summary
- Site Map
Changes
«Changes» — это инструмент, который вы можете использовать для идентификации и отображения изменений в содержимом заархивированных URL.
Начать вы можете с того, что выберите два различных дня какого-то URL. Для этого кликните на соответствующие точки:
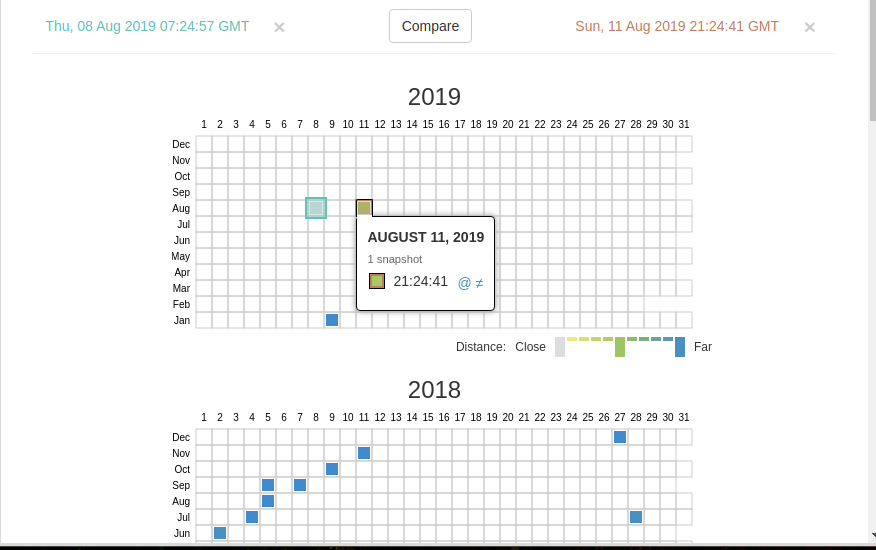
И нажмите кнопку Compare. В результате будут показаны два варианта страницы. Жёлтый цвет показывает удалённый контент, а голубой цвет показывает добавленный контент.
Summary
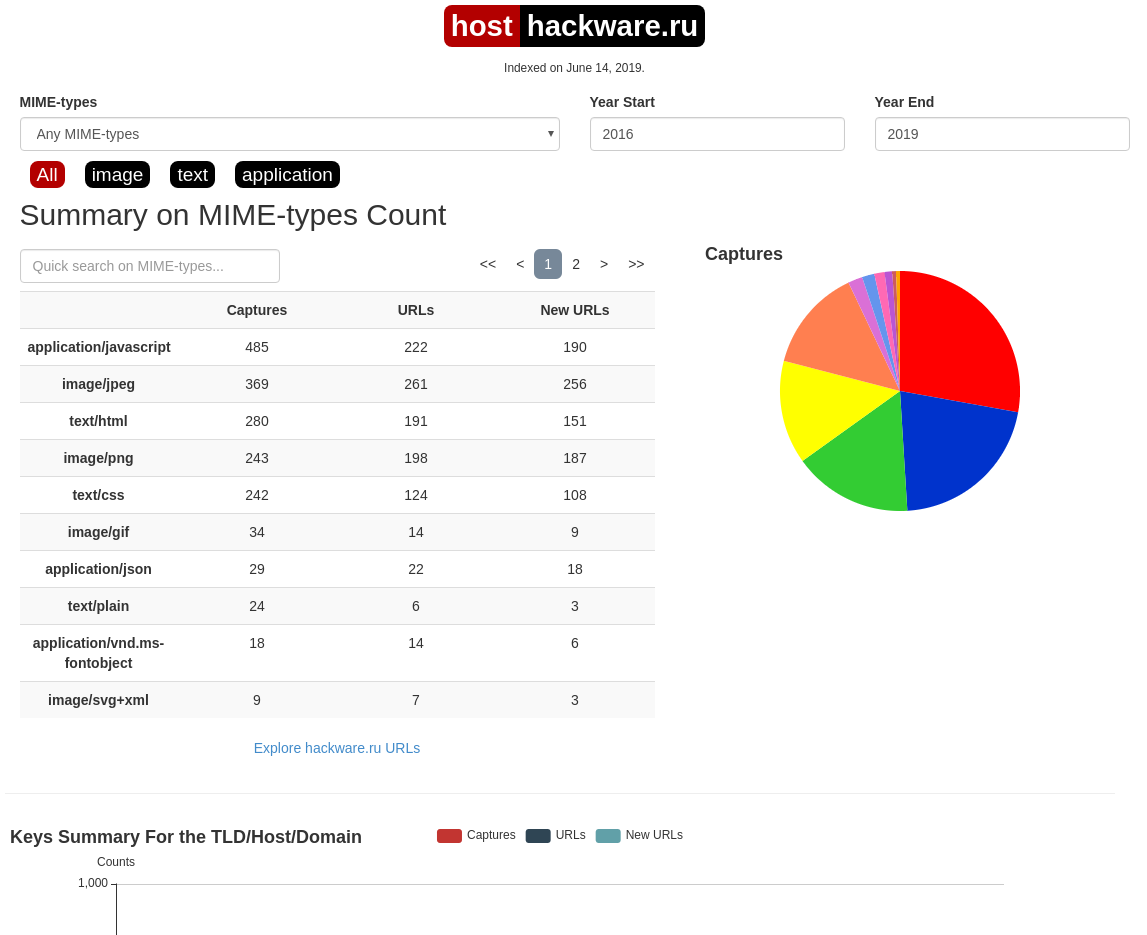
В этой вкладке статистика о количестве изменений MIME-типов.
Site Map
Как следует из название, здесь показывается диаграмма карты сайта, используя которую вы можете перейти к архиву интересующей вас страницы.
Поиск по Интернет архиву
Если вместо адреса страницы вы введёте что-то другое, то будет выполнен поиск по архивированным сайтам:

Показ страницы на определённую дату
Кроме использования календаря для перехода к нужной дате, вы можете просмотреть страницу на нужную дату используя ссылку следующего вида: http://web.archive.org/web/ГГГГММДДЧЧММСС/АДРЕС_СТРАНИЦЫ/
Обратите внимание, что в строке ГГГГММДДЧЧММСС можно пропустить любое количество конечных цифр.
Если на нужную дату не найдена архивная копия, то будет показана версия на ближайшую имеющуюся дату.
archive.md
Адреса данного Архива Интернета:
- http://archive.md
- http://archive.ph/
- http://archive.today/
На главной странице говорящие за себя поля:
- Архивировать страницу, которая сейчас онлайн
- Искать сохранённые страницы

Для поиска по сохранённым страницам можно как указывать конкретный URL, так и домены, например:
- microsoft.com покажет снимки с хоста microsoft.com
- *.microsoft.com покажет снимки с хоста microsoft.com и всех его субдоменов (например, www.microsoft.com)
- http://twitter.com/burgerkingfor покажет архив данного url (поиск чувствителен к регистру)
- http://twitter.com/burg* поиск архивных url начинающихся с http://twitter.com/burg
Данный сервис сохраняет следующие части страницы:
- Текстовое содержимое веб страницы
- Изображения
- Содержимое фреймов
- Контент и изображения загруженные или сгенерированные с помощью Javascript на сайтах Web 2.0
- Скриншоты размером 1024×768 пикселей.
Не сохраняются следующие части веб-страниц:
- Flash и загружаемый им контент
- Видео и звуки
- RSS и другие XML-страницы сохраняются ненадёжно. Большинство из них не сохраняются, или сохраняются как пустые страницы.
Архивируемая страница и все изображения должны быть менее 50 Мегабайт.
Для каждой архивированной страницы создаётся ссылка вида http://archive.is/XXXXX, где XXXXX это уникальный идентификатор страницы. Также к любой сохранённой странице можно получить доступ следующим образом:
- http://archive.is/2013/http://www.google.de/ — самый новый снимок в 2013 году.
- http://archive.is/201301/http://www.google.de/ — самый новый снимок в январе 2013.
- http://archive.is/20130101/http://www.google.de/ — самый новый снимок в течение дня 1 января 2013.
Дату можно продолжить далее, указав часы, минуты и секунды:
- http://archive.is/2013010103/http://www.google.de/
- http://archive.is/201301010313/http://www.google.de/
- http://archive.is/20130101031355/http://www.google.de/
Для улучшения читаемости, год, месяц, день, часы, минуты и секунды могут быть разделены точками, тире или двоеточиями:
- http://archive.is/2013-04-17/http://blog.bo.lt/
- http://archive.is/2013.04.17-12:08:20/http://blog.bo.lt/
Также возможно обратиться ко всем снимкам указанного URL:
- http://archive.is/http://www.google.de/
Все сохранённые страницы домена:
- http://archive.is/www.google.de
Все сохранённые страницы всех субдоменов
- http://archive.is/*.google.de
Чтобы обратиться к самой последней версии страницы в архиве или к самой старой, поддерживаются адреса вида:
- http://archive.is/newest/http://reddit.com/
- http://archive.is/oldest/http://reddit.com/
Чтобы обратиться к определённой части длинной страницы имеется две опции:
- добавить хэштег (#) с позицией прокрутки в качество которого число между 0 (вершина страницы) и 100 (низ страницы). Например, http://archive.md/dva4n#95%
- выбрать текст на страницы и получить URL с хэштегом, указывающим на этот раздел. Например, http://archive.is/FWVL#selection-1493.0-1493.53
В доменах поддерживаются национальные символы:
- http://archive.is/www.maroñas.com.uy
- http://archive.is/*.测试
Обратите внимание, что при создании архивной копии страницы архивируемому сайту отправляется IP адрес человека, создающего снимок страницы. Это делается через заголовок X-Forwarded-For для правильного определения вашего региона и показа соответствующего содержимого.
web-arhive.ru
Архив интернет (Web archive) — это бесплатный сервис по поиску архивных копий сайтов. С помощью данного сервиса вы можете проверить внешний вид и содержимое страницы в сети интернет на определённую дату.
На момент написания, этот сервис, вроде бы, нормально не работает («Database Exception (#2002)»). Если у вас есть по нему какие-то новости, то пишите их в комментариях.
Поиск сразу по всем Веб-архивам
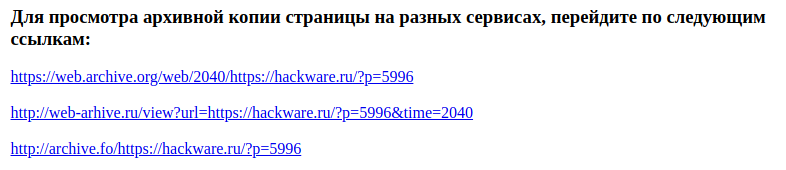
Может так случиться, что интересующая страница или файл отсутствует в веб архиве. В этом случае можно попытаться найти интересующую сохранённую страницу в другом Архиве Интернета. Специально для этого я сделал довольно простой сервис, который для введённого адреса даёт ссылки на снимки страницы в рассмотренных трёх архивах.
Что делать, если удалённая страница не сохранена ни в одном из архивов?
Архивы Интернета сохраняют страницы только если какой-то пользователь сделал на это запрос — они не имеют функции обходчиков и ищут новые страницы и ссылки. По этой причине возможно, что интересующая вас страница оказалась удалено до того, как была сохранена в каком-либо веб-архиве.
Тем не менее можно воспользоваться услугами поисковых движков, которые активно ищут новые ссылки и оперативно сохраняют новые страницы. Для показа страницы из кэша Google нужно в поиске Гугла ввести
cache:URL
cache:https://hackware.ru/?p=6045
Если ввести подобный запрос в поиск Google, то сразу будет открыта страница из кэша.
Для просмотра текстовой версии можно использовать ссылку вида:
- http://webcache.googleusercontent.com/search?q=cache:URL&strip=1&vwsrc=0
Для просмотра исходного кода веб страницы из кэша Google используйте ссылку вида:
- http://webcache.googleusercontent.com/search?q=cache:URL&strip=0&vwsrc=1
Например, текстовый вид:
Как полностью скачать сайт из веб-архива
Если вы хотите восстановить удалённый сайт, то вам поможет программа Wayback Machine Downloader.
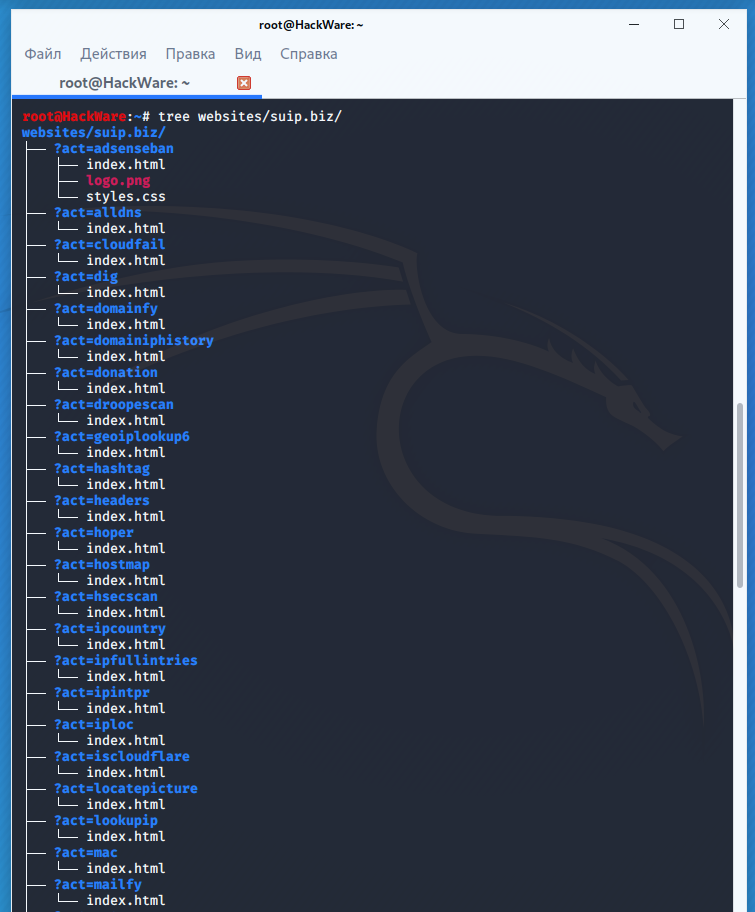
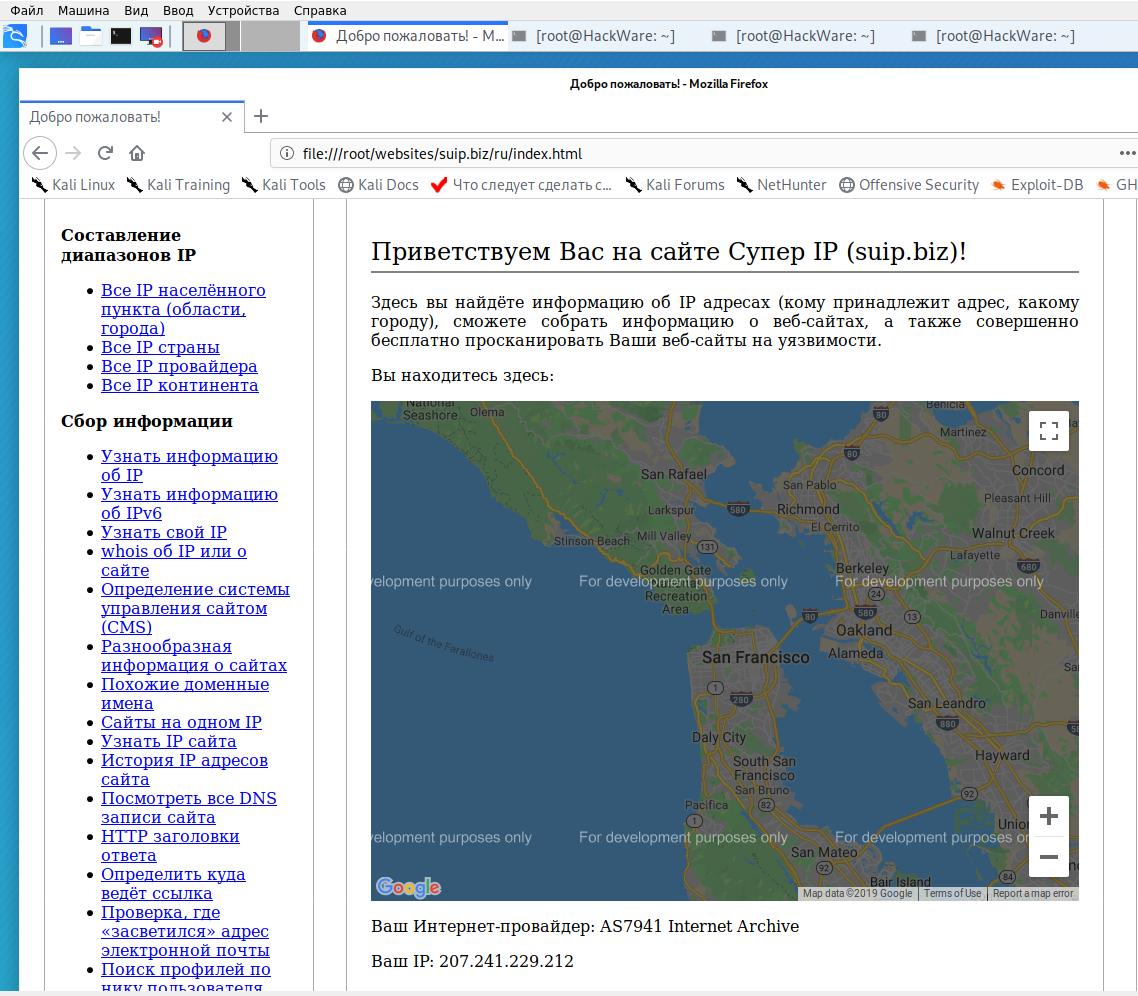
Программа загрузит последнюю версию каждого файла, присутствующего в Архиве Интернета Wayback Machine, и сохранить его в папку вида ./websites/example.com/. Она также пересоздаст структуру директорий и автоматически создаст страницы index.html чтобы скаченный сайт без каких либо изменений можно было бы поместить на веб-сервер Apache или Nginx.
Об установке программы и дополнительных опциях смотрите на странице https://kali.tools/?p=5211
Пример скачивания полной копии сайта suip.biz из веб-архива:
wayback_machine_downloader https://suip.biz
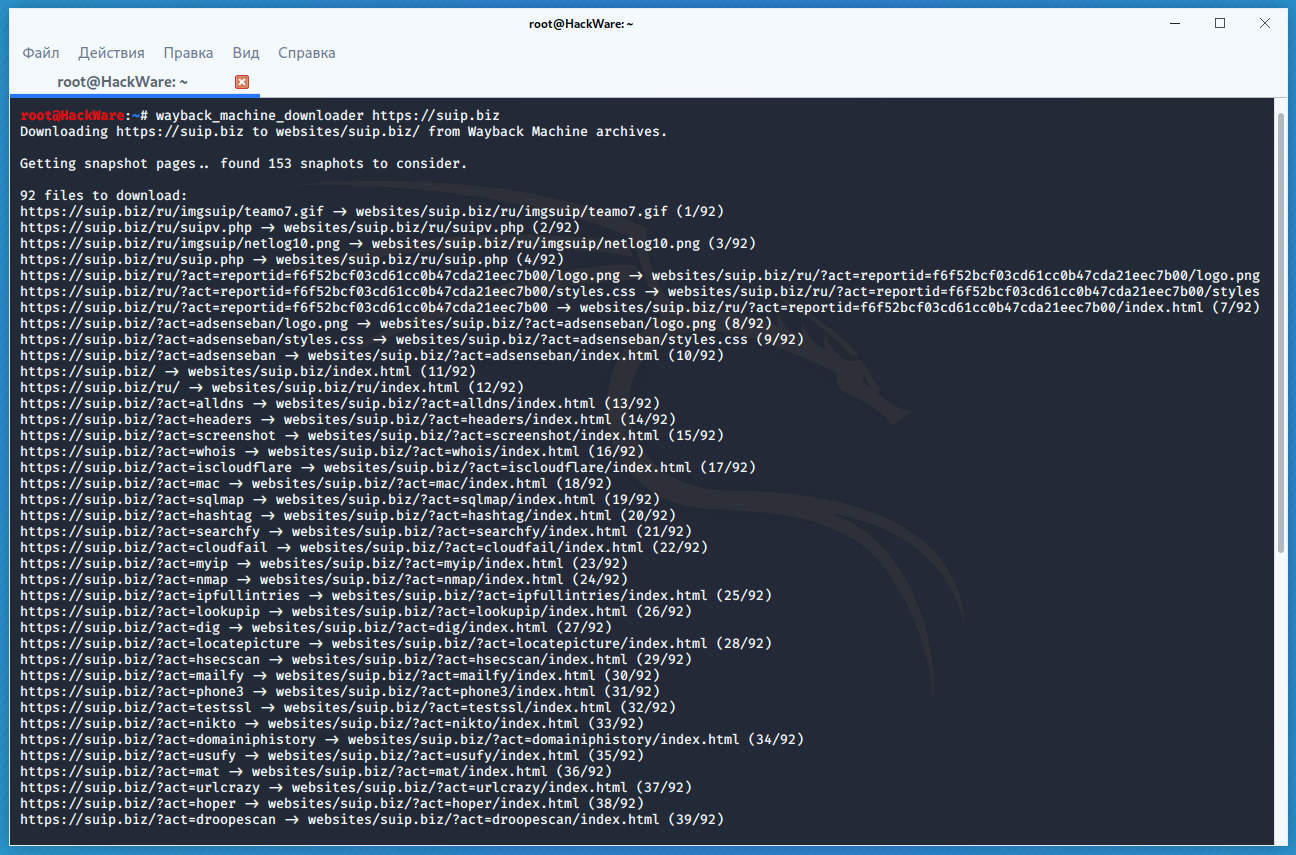
Структура скаченных файлов:
Локальная копия сайта, обратите внимание на провайдера Интернет услуг:
Как скачать все изменения страницы из веб-архива
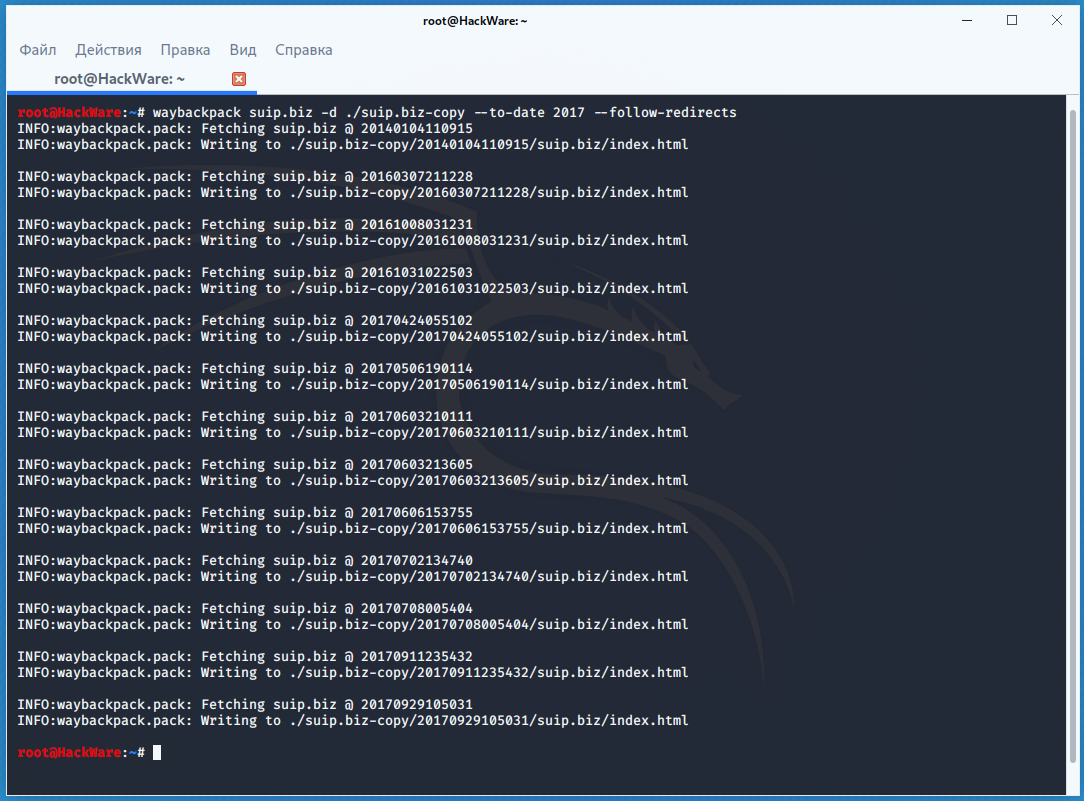
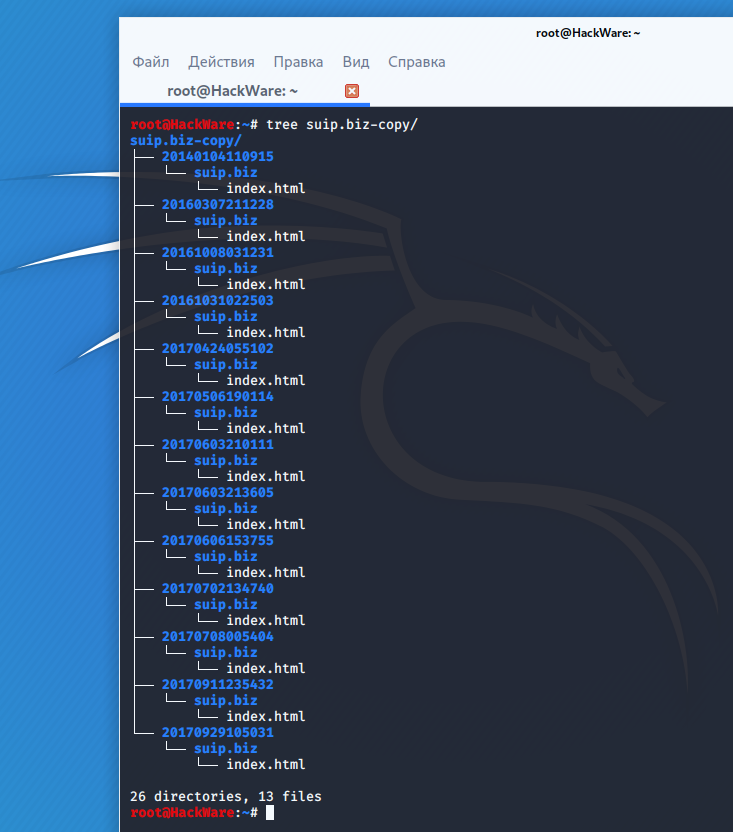
Если вас интересует не весь сайт, а определённая страница, но при этом вам нужно проследить все изменения на ней, то в этом случае используйте программу Waybackpack.
К примеру для скачивания всех копий главной страницы сайта suip.biz, начиная с даты (—to-date 2017), эти страницы должны быть помещены в папку (-d /home/mial/test), при этом программа должна следовать HTTP редиректам (—follow-redirects):
waybackpack suip.biz -d ./suip.biz-copy --to-date 2017 --follow-redirects
Чтобы для указанного сайта (hackware.ru) вывести список всех доступных копий в веб-архиве (—list):
waybackpack hackware.ru --list
Как узнать все страницы сайта, которые сохранены в веб-архиве
Для получения ссылок, которые хранятся в Архиве Интернета, используйте программу waybackurls.
Эта программа извлекает все URL указанного домена, о которых знает Wayback Machine. Это можно использовать для быстрого составления карты сайта.
Чтобы получить список всех страниц о которых знает Wayback Machine для домена suip.biz:
echo suip.biz | waybackurls
Заключение
Предыдущие три программы рассмотрены совсем кратко. Дополнительную информацию об их установке и об имеющихся опциях вы сможете найти по ссылкам на карточки этих программ.
Ещё парочка программ, которые работают с архивом интернета:
- https://github.com/relrelb/wayback-downloader
- https://github.com/erlange/wbm-dl
Связанные статьи:
- Инструкция по использованию HTTrack: создание зеркал сайтов, клонирование страницы входа (79.2%)
- badKarma: Продвинутый набор инструментов для сетевой разведки (79.2%)
- Обход файерволов веб приложений Cloudflare, Incapsula, SUCURI (74.3%)
- FinalRecon: простой и быстрый инструмент для сбора информации о сайте, работает и на Windows (74.3%)
- Сбор информации о владельце сайта. Поиск сайтов одного лица (53.5%)
- Поиск субдоменов (поддоменов) без брут-форса (RANDOM — 53.5%)
факультете информационной безопасности от GeekBrains? Комплексная годовая программа практического обучения с охватом всех основных тем, а также с дополнительными курсами в подарок. По итогам обучения выдаётся свидетельство установленного образца и сертификат. По этой ссылке специальная скидка на любые факультеты и курсы!
Вернуться в прошлое? Легко! Рассказываем про Wayback Machine
Вы когда-нибудь задумывались, как выглядели популярные сайты на заре интернета? Может быть случалось такое, что вы «всё уронили» при смене дизайна, забыв про бэкап? Со всеми этими вопросами помогут разобраться «сайты-машины-времени». О них сегодня и поговорим.
Что такое Wayback Machine?
Wayback Machine (вебархив) — самый известный сайт-архив WWW (World Wide Web), основанный некоммерческой организацией «Internet Archive» из Сан-Франциско.
Суть в том, что с помощью специальной программы, все страницы в интернете сканируются и архивируются, чтобы любой пользователь мог просмотреть историю изменений даже спустя годы. На момент публикации нашей статьи на сайте ARCHIVE.ORG увековечена история более 720 миллиардов страниц — и это число продолжает расти не то что с каждым днем, а с часом!
Зачем же пользователям возвращаться в прошлое?
Причин может быть несколько:
- Восстановление потерянных данных. Используя онлайн-машину времени, вы сможете восстановить любой утраченный контент, например, найти ссылку на удаленное видео или восстановить внешний вид внезапно сломавшегося плагина.
- Просмотр содержимого неработающего веб-сайта. Возможно, что-то пошло не так и сайт полностью упал. Но на сервис Wayback Machine никак не влияет работоспособность вашей страницы, поэтому всё утраченное легко будет восстановить с помощью снапшотов.
- Анализ конкурентов. Согласитесь, что иногда очень полезно рассмотреть и проанализировать ваших конкурентов: как они пришли из точки А в успешную точку Б, как менялся их сайт, какие услуги добавляли, от каких проектов им пришлось отказаться и так далее.
- Интерес и ностальгия. Может быть вы просто хотите окунуться в приятные воспоминания, поностальгировать о временах, когда только начинали свое онлайн-дело, и «вернуть свой 2007».
Снапшот — мгновенный снимок сервера, который может быть использован как для резервного копирования и последующего восстановления, так и для удобства разворачивания данных на новых серверах.
Вебархив, конечно, титан-прародитель среди подобных сервисов. Но все же это не единственный сайт, способный вернуть вас в прошлое. Поэтому спешим рассказать о парочке неплохих бесплатных альтернатив Wayback Machine.
Archive.today
Archive.today — платформа для архивирования и хороший аналог вебархива. Основное преимущество сервиса — его способность поддерживать сайты на Visual Basic, JavaScript.
Еще одна крутая фишка сервиса в том, что он использует две топовые поисковые системы: Google и Яндекс. Поэтому всякий раз, когда одна поисковая система вдруг перестанет работать из-за сбоев, сервис автоматически заменяет ее на другую — ни один снапшот не будет упущен!
Но обращаем внимание, что используя сервис, пользователи могут получить доступ к сайту, если его размер не превышает 50 МБ.
Time Travel
Time Travel — еще один бесплатный и простой в использовании аналог WayBack Machine, с помощью которого вы тоже сможете вернуться в прошлое и посмотреть снапшоты сайта в нужный момент времени.
Дизайн прост, всё интуитивно понятно — вводите URL-адрес и вперед.
Visualping
Visualping — сайт, с небольшим минусом — с его помощью нельзя вернуться в прошлое просто так. Чтобы начать отслеживать изменений веб-сайта, нужно ввести URL-адрес страницы, которую вы хотите отслеживать, и выбрать период сохранения изменений. Также понадобится ваша почта, на которую сервис будет автоматически отправлять снапшоты.
Используя Visualping, вы сможете сканировать все виды веб-сайтов: обновления социальных сетей или страниц, защищенных паролем.
CacheView
А как насчет сайта, который архивирует сайта из трех различных источников (Coral, Wayback Machine и Google Cache). Крутая фишка сервиса в том, что он позволяет получить доступ к кэшу Google.
Yubnub
Yubnub — еще один простой и удобный инструмент из нашей подборки. С его помощью вы также сможете легко найти любую базовую информацию об изменениях страницы. Хорошая альтернатива с очаровательной улиткой.
Расскажите о своем опыте использования подобных сервисов в комментариях — бывало ли такое, что они спасали ваш сайт?
А мы просто напомним, как важно не забывать про резервные копии и снапшоты.


