Поисковые технологии или в чем загвоздка написать свой поисковик
Когда-то давно взбрела мне в голову идея: написать свой собственный поисковик. Было это очень давно, тогда я еще учился в ВУЗе, мало чего знал про технологии разработки больших проектов, зато отлично владел парой десятков языков программирования и протоколов, да и сайтов своих к тому времени было понаделано много.
Ну есть у меня тяга к монструозным проектам, да…
В то время про то, как они работают было известно мало. Статьи на английском и очень скудные. Некоторые мои знакомые, которые были тогда в курсе моих поисков, на основе нарытых и мной и ими документов и идей, в том числе тех, которые родились в процессе наших споров, сейчас делают неплохие курсы, придумывают новые технологии поиска, в общем, эта тема дала развитие довольно интересным работам. Эти работы привели в том числе к новым разработкам разных крупных компаний, в том числе Google, но я лично прямого отношения к этому не имею.
На данный момент у меня есть собственный, обучающийся поисковик от и до, со многими нюансами – подсчетом PR, сбором статистик-тематик, обучающейся функцией ранжирования, ноу хау в виде отрезания несущественного контента страницы типа меню и рекламы. Скорость индексации примерно полмиллиона страниц в сутки. Все это крутится на двух моих домашних серверах, и в данный момент я занимаюсь масштабированием системы на примерно 5 свободных серверов, к которым у меня есть доступ.
Здесь я в первый раз, публично, опишу то, что было сделано лично мной. Думаю, многим будет интересно как же работают Яндекс, Google и почти все мне известные поисковики изнутри.
Есть много задач при построении таких систем, которые почти нереально решить в общем случае, однако с помощью некоторых ухищрений, придумок и хорошего понимания как работает железячная часть Вашего компьютера можно серьезно упростить. Как пример – пересчет PR, который в случае нескольких десятков миллионов страниц уже невозможно поместить в самой большой оперативной памяти, особенно если Вы, как и я, жадны до информации, и хотите кроме 1 цифры хранить еще много полезностей. Другая задача – хранение и обновление индекса, как минимум двумерной базы данных, в которой конкретному слову сопоставляется список документов, на которых оно встречается.
Просто вдумайтесь, Google хранит, по одной из оценок, более 500 миллиардов страниц в индексе. Если бы каждое слово встречалось на 1 странице только 1 раз, и на хранение этого надо было 1 байт – что невозможно, т.к. надо хранить хотя бы id страницы – уже от 4 байт, так вот тогда объем индекса бы был 500гб. В реальности одно слово встречается на странице в среднем до 10 раз, объем информации на вхождение редко когда меньше 30-50 байт, весь индекс увеличивается в тысячи раз… Ну и как прикажите это хранить? А обновлять?
Ну вот, как это все устроено и работает, я буду рассказывать планомерно, так же как и про то как считать PR быстро и инкрементально, про то как хранить миллионы и миллиарды текстов страниц, их адреса и быстро искать по адресам, как организованы разные части моей базы данных, как инкрементально обновлять индекс на много сотен гигов, ну и наверное расскажу как сделать обучающийся алгоритм ранжирования.
На сегодня объем только индекса, по которому происходит поиск — 57Gb, увеличивается каждый день примерно на 1Gb. Объем сжатых текстов – 25Gb, ну и я храню кучу другой полезной инфы, объем которой очень трудно посчитать из-за ее обилия.
Как я написал свою поисковую систему для быстрого поиска личной информации
Все началось с того, что мне стало трудно находить нужную информацию, файлы. Чем больше файлов и папок у меня образовывалось, тем больше времени уходило на поиски нужного. Я понял, что каждый раз искать в бесконечных списках файлов и папок, особенно с условием вложенности это не вариант для больших объемов данных.
Что касается поиска по названию файла, то количество символов, указанных в названии ограниченно и слова при поиске должны быть в строго определенной последовательности. Тем более, если система индексирует другие, не нужные для поиска файла (системные файлы, файлы проектов), то поиск выдает много «мусора».
Поиск по содержанию файла даёт не самый релевантный результат. Может выдать бесполезные результаты с содержанием содержащие ключевые слова, но не относящиеся к тому, что действительно необходимо найти.
Более того по содержанию можно искать только текстовые файлы.
Структура содержания информации
Структура папок представляется собой в виде дерева. Мне это не нравится, потому что каждая папка может содержать только определенные файлы, если не учитывать копирование и ссылки.
Так же это можно представить с примером из реальной жизни, для того, чтобы найти зелёное свежее яблоко сорт «девственный». Необходимо найти отдел с фруктами, затем отдел с яблоками, затем ищем зеленные, затем сорт, ну там ещё их на свежие, не свежие фасуют в этом воображаемом примере и наконец найти нужное apple.
Усложняется ещё все и тем, что я не помню есть ли там вообще яблоки, и если есть, то хранятся ли они в отделе фрукты там продаются.
А почему бы об этом просто не попросить прихвостня(они уже у всех есть, правда?) -«Принеси мне зелёное свежее яблоко».
Как сразу становится удобно!
В общем, всем этим я хочу сказать, что поиск нужной информации в папках хорош, если папок немного и если помнить какие папки существуют, а не перебирать все подряд.
А вот если мы не знаем существуют ли яблоки вообще, то спрашиваем прихвостня:
— «Есть, господин! Сотни, игрушечные, красные, гнилые..».
— «Мне нужно свежее яблоко».
— «Понял! Есть красное свежее яблоко «Сирота», красное свежее яблоко «курага». ».
— «А что насчёт зелёного свежего яблока».
— «Есть! Зелёное свежее яблоко «Пух-тибидух» и Зелёное свежее яблоко «Девственный»».
— «В таком случае, принеси мне, пожалуй, Зелёное свежее яблоко «Девственный»».
Вот последняя фраза как раз таки и стала названием приложения. Как ответ на команду пользователя — «Yes Sir».
Возвращаясь к яблокам. Заметили, что в первом случае нужно искать яблоки не пойми где, а во втором мы задаём уточняющие условия к запросу! ?
Для нахождения нужного результата, используя древовидную структуру(папки) приходится обходить все узлы. А в случае графа(теги) можно получить результат, в лучше случае за проход по единственному узлу.
Приведу пример более реалистичный. Есть папка с музыкой и подпапки для разделения на жанры. Но что если в какой-то момент мне захочется послушать французскую музыку не зависимо от жанра. Вот тут то и вся проблемность древовидной структуры папок вылазит. Можно конечно, как советовали на форумах, создавать отдельные папки под язык произведения и кидать ссылки, но опяяяттть папкии..
А вот, что произойдет, если каждому файлу установить теги с жанром, языком, ну и конечно что это музыка, песня.
В этом случае возможно группировать, сортировать музыку гораздо гибче. Например скомбинировав 3 тега: французская, русская, рок можно получить то, чего стандартными средствами Windows не возможно, ну или я чего-то не знаю.
Попытки найти готовое решение.
Первой идеей было воспользоваться «тегированием» файлов, папок. Таким образом можно искать информацию комбинируя теги, не зависимо от порядка слов. И лучшими приложениями для этого, могу выделить XYplorer и Tagging for windows. Первая из себя представляет отдельный файловый менеджер с опцией тегирования. Второе приложение — дополнение к стандартному файловому менеджеру. Однако они позволяют искать файлы только на ПК и конечно нельзя написать как в Гугл поисковике запрос близкий к пользователю, а алгоритм уже бы сам выбрал из запроса теги и отсортировал информацию по приоритету. В последствии удалил обе, они подвисали и крашились частенько (возможно дело в моих надстройках Windows, не хочу делать антипиар этих отличных программ).
Визуальный поиск
В попытках найти оптимальный способ поиска доходило до странного. Я больше визуал и поэтому загружал изображения более менее подходящее по теме информации в социальную сеть ВКонтакте, а саму информацию сохранял в комментариях под изображениями. Это дало некоторый прирост в скорости поиска и пользоваться можно с любого устройства. Но как вы, наверное, понимаете долго это продолжаться не могло. В конечном итоге я стал задумываться а к какой информации относится это изображение : «Рельсы означает адреса знакомых или желаемые места для путешествия..». Ну а уж то, что под одним изображением образуется портянка из информации без возможности вложенности — это фиаско, бро.
Как я написал свою поисковую систему для быстрого поиска личной информации
Как создать собственную поисковую систему для быстрого поиска личной информации с применением метода графов или тэгов.
Все началось с того, что мне стало трудно находить нужную информацию, файлы. Чем больше файлов и папок у меня образовывалось, тем больше времени уходило на поиски нужного. Я понял, что каждый раз искать в бесконечных списках файлов и папок, особенно с условием вложенности это не вариант для больших объемов данных.
Что касается поиска по названию файла, то количество символов, указанных в названии ограниченно и слова при поиске должны быть в строго определенной последовательности. Тем более, если система индексирует другие, не нужные для поиска файла (системные файлы, файлы проектов), то поиск выдает много «мусора».
Курс «Java для Android-разработчиков»
Поиск по содержанию файла даёт не самый релевантный результат. Может выдать бесполезные результаты с содержанием содержащие ключевые слова, но не относящиеся к тому, что действительно необходимо найти.
Более того, по содержанию можно искать только текстовые файлы.
Ссылка на проект — тут.
Структура содержания информации
Структура папок представляется собой в виде дерева. Мне это не нравится, потому что каждая папка может содержать только определенные файлы, если не учитывать копирование и ссылки.
Так же это можно представить с примером из реальной жизни, для того, чтобы найти зелёное свежее яблоко сорт «Девственный». Необходимо найти отдел с фруктами, затем отдел с яблоками, затем ищем зеленные, затем сорт, ну там ещё их на свежие, не свежие фасуют в этом воображаемом примере и наконец найти нужное apple.
Усложняется ещё все и тем, что я не помню есть ли там вообще яблоки, и если есть, то хранятся ли они в отделе фрукты.
А почему бы об этом просто не попросить прихвостня (они уже у всех есть, правда?): «Принеси мне зелёное свежее яблоко».
Как сразу становится удобно!
В общем, всем этим я хочу сказать, что поиск нужной информации в папках хорош, если папок немного и если помнить какие папки существуют, а не перебирать все подряд.
А вот если мы не знаем существуют ли яблоки вообще, то спрашиваем прихвостня:
— Есть, господин! Сотни, игрушечные, красные, гнилые….
— Мне нужно свежее яблоко.
— Понял! Есть красное свежее яблоко «Сирота», красное свежее яблоко «Курага», …
— А что насчёт зелёного свежего яблока.
— Есть! Зелёное свежее яблоко «Пух-тибидух» и Зелёное свежее яблоко «Девственный».
— В таком случае, принеси мне, пожалуй, Зелёное свежее яблоко «Девственный».
Вот последняя фраза как раз таки и стала названием приложения. Как ответ на команду пользователя — «Yes Sir».
Возвращаясь к яблокам. Заметили, что в первом случае нужно искать яблоки не пойми где, а во втором мы задаём уточняющие условия к запросу?
Приведу пример более реалистичный. Есть папка с музыкой и подпапки для разделения на жанры. Но что если в какой-то момент мне захочется послушать французскую музыку не зависимо от жанра. Вот тут то и вся проблемность древовидной структуры папок вылазит. Можно конечно, как советовали на форумах, создавать отдельные папки под язык произведения и кидать ссылки, но опять папки…
А вот, что произойдет, если каждому файлу установить теги с жанром, языком, ну и конечно что это музыка, песня.
В этом случае возможно группировать, сортировать музыку гораздо гибче. Например, скомбинировав 3 тега: французская, русская, рок можно получить то, чего стандартными средствами Windows не возможно, ну или я чего-то не знаю.
Попытки найти готовое решение
Первой идеей было воспользоваться «тегированием» файлов, папок. Таким образом можно искать информацию комбинируя теги, не зависимо от порядка слов. И лучшими приложениями для этого, могу выделить XYplorer и Tagging for windows. Первая из себя представляет отдельный файловый менеджер с опцией тегирования. Второе приложение — дополнение к стандартному файловому менеджеру. Однако они позволяют искать файлы только на ПК и конечно нельзя написать как в Гугл поисковике запрос близкий к пользователю, а алгоритм уже бы сам выбрал из запроса теги и отсортировал информацию по приоритету. В последствии удалил обе, они подвисали и крашились частенько (возможно дело в моих надстройках Windows, не хочу делать анти пиар этих отличных программ).
Визуальный поиск
В попытках найти оптимальный способ поиска доходило до странного. Я больше визуал и поэтому загружал изображения более менее подходящее по теме информации в социальную сеть ВКонтакте, а саму информацию сохранял в комментариях под изображениями. Это дало некоторый прирост в скорости поиска и пользоваться можно с любого устройства. Но как вы, наверное, понимаете долго это продолжаться не могло. В конечном итоге я стал задумываться а к какой информации относится это изображение, на котором рельсы — означает адреса знакомых или желаемые места для путешествия… Ну а уж то, что под одним изображением образуется портянка из информации без возможности вложенности — это фиаско, бро.
Желаемый функционал
Я подумал, что было бы отлично разработать приложение, которое бы подходило по таким критериям:
- Можно использовать с любого устройства без возможности подключения к интернету.
- Поиск личной информации настолько быстро, насколько это возможно.
- Поиск должен быть простым как Google Search.
- Возможность сохранить всю текстовую информацию в текстовый файл.
Выбор технологий
1. По первому пункту из желаний было решено разработать веб приложение, так как с любого устройства, на котором есть браузер, можно получить к нему доступ. Данные хранятся в localstorage браузера, но при открытии сайта сразу выгружаются в переменную для обеспечения лучшей скорости.
Для синхронизации данных с другим устройством, браузером я взял базу данных mysql от 000webhost бесплатно, но потом перестал использовать из-за ограничений на объем. Сейчас единственный способ для обновления пользовательских данных — импорт и экспорт файла. Однако я делаю это очень редко, т.к. в основном пользуюсь только со смартфона. Что касается офлайн режима — я использовал serviceworking. Необходимо только один раз зайти на сайт, чтобы все ресурсы сайта загрузились и дальше использовать полностью офлайн из браузера.
2. Быстрый поиск.
Раз поиск должен осуществляться подобно Гугл поисковику, то нужно чтобы каждое слово из запроса проверять на существующий из уже созданного блока информации. Таким блоком у меня выступает объект с ключами: уникальное название блока, действие(показать информацию, открыть ссылку…), содержимое, теги.
Итак, по ключу «теги» у нас будет храниться массив из символов(слов) для конкретного блока информации.
Сразу возьмём пример блока.
Название: как создать сайт.
Действие: показать информацию.
Содержимое: берём html, добавляем js и украшаем css.
Теги: создание сайта, веб программирование, верстка.
Массив из тегов формируется из текстов полученных с полей ввода для тегов и названия. Каждое слово это тег, разделять можно запятой и пробелом. Была идея конечно сделать как на Ютубе, теги как словосочетания, но я решил остановиться на более широкой выдаче по ключевым словам. Из примера блока выше массив тегов будет таким: [«как», «создать», «сайт», «создание», «сайта», «веб», «программирование», «верстка»].
Теперь самое важное — определиться как будет происходить поиск. Первое, что пришло в голову это брать каждое слово из поискового запроса и сравнивать с каждым словом из тега каждого блока. В голову как пришло, так и ушло, это отвратительная идея. Следующей идеей было создание объекта, в котором каждый тег это отдельный ключ, а значение это массив из индексов блоков.
3. Итак, при вводе запроса проверяется есть ли слово в хранилище тегов, если да, то блок добавляется в массив на отображение.Теперь нужно отсортировать по приоритету. Чем выше результат в выдаче, тем более он подходит запросу. Это я реализовал с помощью количества ключевых слов в запросе, чем больше слов из запроса содержится в массиве тегов блока, тем более блок приоритетнее.
4. И насчёт сохранение в файл совсем кратко. Можно сохранять и импортировать файл в виде json.Так же мой опыт с использованием ВКонтакте как поисковик по изображениям дал мне идею для возможности добавлять изображение к каждому блоку при желании.
Итоги
В результате я сделал то, чем пользуюсь уже больше года. Как веб, так и ПК версия оказались очень полезными. Использую для работы и личной жизни. Скорость поиска, которую я в итоге получил меня многократно выручала, когда нужно было найти что-то очень быстро.
Ответвление в другие проекты
Веб приложение мне настолько понравилось, что я захотел написать программу для исполнения программ по команде от запроса пользователя на ПК. Вдохновлённый голосовыми помощниками, я создал программу, которая ищет и исполняет файлы. А поиск соответственно так же подобен веб поисковику. Особенность в том, что можно перетащить файл/файлы напрямую в программу и алгоритм автоматически установит теги исходя из названия файла и папок, в которых он содержится. Но это тема другого поста, если этот окажется интересным.
Послесловие
Буду рад любым комментариям. Узнать ваше мнение по поводу идеи. Полная ли это ерунда. Или, в чем я почти не сомневаюсь, есть уже приложения с подобной реализацией. Спасибо!
Как сделать поисковую систему с ИИ, используя FastAPI, Qdrant и ChatGPT
Из-за шумихи вокруг Bing AI и Bard у меня возникло желание создать свою маленькую поисковую систему с искусственным интеллектом. Повозившись несколько дней, я выпустил Ask Seneca. Это небольшое приложение на основе GPT, с помощью которого можно поболтать с Сенекой (это древнеримский философ, если что). Когда пользователь задаёт вопрос, Ask Seneca ищет наиболее релевантные записи, а затем объединяет их в связный ответ, иногда вставляет известные высказывания своего прообраза.
Несмотря на косяки, которыми грешат Bing AI и Bard, потенциал этой технологии огромен — вы можете создавать инструменты для быстрого и эффективного поиска в юридических документах, внутренних базах знаний, руководствах по продуктам и т. д.
Я покажу, как создать собственную поисковую систему с искусственным интеллектом на основе FastAPI , Qdrant , Sentence Transformers и GPT-3. Вы сможете задавать вопросы Марку Аврелию и получать краткие ответы со ссылками на его «Размышления» (личные записи великого римского императора).
Что нужно знать
Чтобы создать свой мини-поисковик, нужно разбираться в следующих вопросах:
- Что такое семантический поиск.
- Что такое векторные базы данных.
- Что такое FastAPI и как его использовать.
Вам не обязательно быть экспертом в какой-либо из этих областей, но хотя бы поверхностное знакомство поможет лучше понять, о чём я буду говорить дальше.
Разработка (крошечной) поисковой системы с помощью ChatGPT
Прежде чем приступить к работе, вы должны понять общий подход, который будем использовать для создания поисковой системы с ИИ. Он состоит из трёх частей:
- Извлечение: Здесь происходит извлечения данных, которые будут доступны пользователю для поиска. В нашем случае это означает разбор Размышлений Марка Аврелия. Я не буду вдаваться в подробности, потому что это узкая специфика проекта. Готовый парсинг данных доступен в репозитории.
- Индексирование: Следом необходимо выполнить индексирование извлеченных данных, чтобы к ним можно было получить доступ позже в процессе поиска. Здесь будет использоваться подход семантического поиска, то есть данные будут искаться по смыслу, а не по ключевым словам. То есть, на поисковый запрос «Как стать счастливым?» вы должны получить отрывки из «Размышлений», где говорится о счастье или хорошем самочувствии, а не только те, в которых содержатся точные слова из запроса.
- Поиск: Сюда входит серверная служба, которая обрабатывает запрос пользователя, векторизует его, находит в индексе векторы, наиболее похожие на него, а затем вызывает API OpenAI для создания сводного ответа пользователю.
Вот как части приложения сочетаются друг с другом:

Настройте свою локальную среду
Выполните следующие действия, чтобы подготовить локальную среду:
- Установите Python 3.10 .
- Установить Poetry. Это не обязательно, но я очень рекомендую.
- Клонируйте репозиторий с образцом приложения:
git clone https://github.com/dylanjcastillo/ai-search-fastapi-qdrant-chatgpt
- Перейдите в корневую папку проекта и установите зависимости с:
- Poetry: Создайте виртуальную среду в том же каталоге, что и проект, и установите зависимости: poetry config virtualenvs.in-project true poetry install
- venv и pip: Создайте виртуальную среду и установите зависимости, перечисленные в разделе: python3.10 -m venv .venv && source .venv/bin/activate pip install -r requirements.txt
Имейте в виду, что PyTorch пока не поддерживает Python 3.11 в MacOS и Windows.
Если все прошло успешно, у вас должна получиться виртуальная среда со всеми необходимыми библиотеками и структурой проекта, которая выглядит следующим образом:
ai-search-fastapi-qdrant-gpt3 │ ├── README.md ├── config.py ├── data │ ├── processed │ │ └── Marcus_Aurelius_Antoninus. │ │ └── Marcus_Aurelius_Antoninus. json │ └── unzipped │ └── Marcus_Aurelius_Antoninus. │ ├── index.html │ ├── metadata.opf │ └── style.css ├── main.py ├── notebooks │ ├── extract_text.ipynb │ └── vectorize_text.ipynb ├── poetry.lock ├── pyproject.toml ├── requirements.txt ├── .env-example └── .venv/Это структура нашего проекта. Далее объясню назначение наиболее важных файлов и каталогов:
- config.py : этот файл содержит спецификации конфигурации проекта, такие как хост Qdrant, порт и ключ API (чтение из файла .env).
- data/ : этот каталог содержит данные проекта. Здесь находятся «Размышления», изначально выгруженные из Википедии, а также обработанный файл, который вы будете использовать в проекте.
- main.py : этот файл содержит код приложения FastAPI.
- notebooks/ : этот каталог содержит записные книжки Jupyter для извлечения, векторизации и индексации данных. extract_text.ipynb содержит код для анализа файла HTML, а vectorize_text.ipynb содержит код для векторизации и индексации данных.
- poetry.lock и pyproject.toml : эти файлы содержат информацию о зависимостях проекта и используются Poetry для репликации среды.
- requirements.txt : этот файл содержит список пакетов Python, необходимых для проекта.
- .env-example : этот файл является примером переменных среды, которые вы должны предоставить.
- .venv/ : этот каталог содержит виртуальную среду проекта.
Настройте Qdrant и OpenAI
Начнём с переименования .env-example в .env. Сейчас думать о заполнении значений в .env. не нужно. Когда вы создадите кластер и ключи API для Qdrant и OpenAI, то заполните эти пробелы.
Qdrant
Создайте учётную запись в Qdrant, если у вас её ещё нет. Затем на странице своей учётной записи перейдите в Clusters > Create и создайте кластер из 1 ГБ ОЗУ, 0,5 vCPU и диска на 20 ГБ. Qdrant предлагает щедрый тестовый доступ, так что вы можете бесплатно запустить кластер с такими характеристиками.

Затем вставьте хост и ключ API, полученные при создании кластера, в .env :
QDRANT_PORT=6333 QDRANT_HOST= QDRANT_API_KEY=
Если вы не копировали ключ, то можете создать новый в Access.
Наконец, вы можете проверить, всё ли хорошо, запустив первые три ячейки в файле vectorize_data.ipynb .
OpenAI
Если у вас нет учетной записи OpenAI, создайте ее (а вот инструкция для россиян). После этого перейдите в Manage account > API keys > + Create new secret key.

Затем вставьте сгенерированный ключ в .env :
QDRANT_PORT=6333 QDRANT_HOST= QDRANT_API_KEY= OPENAI_API_KEY= # newИзвлечение данных
Процесс извлечения данных может сильно различаться в зависимости от проекта, поэтому я не буду вдаваться в подробности.
Вот несколько полезных рекомендаций, которые стоит учесть:
- Хрень на входе — хрень на выходе. Качество данных сильно влияет на результаты поиска, поэтому не торопитесь.
- Разделение документов. Когда вы выполняете семантический поиск, вам нужно разделить документы на более мелкие фрагменты, чтобы можно было сравнить каждый фрагмент с запросом пользователя. Нет правильного или неправильного способа сделать это. Лично я делил текст на абзацы, а если абзац был слишком длинный для векторизатора, делил его на несколько предложений.
Вывод: стоит подумать, как часто вы будете извлекать и принимать данные, адаптировать свой конвейер для различных источников данных (например, парсинг, API) и создавать мониторы конвейера. В этом примере, поскольку извлечение данных является разовым мероприятием, я использую Jupyter Notebook, но это не всегда хорошая идея.
Вот краткий обзор данных из этого блока:
Сюда входят общие метаданные, такие как название книги и исходный URL-адрес, а также информация из каждой главы с предложениями, которые вы индексируете. Если вы хотите посмотреть, как я извлёк данные, используемые в этом руководстве, ознакомьтесь с файлом extract_data.ipynb.
Векторизация и индексация данных
После того, как вы извлекли данные, их нужно проиндексировать в векторной базе данных.
Процесс состоит из двух шагов:
- Создайте векторы для каждого предложения, которое было извлечено ранее.
- Вставьте эти векторы в коллекцию (набор векторов, который вы можете искать в базе данных).
Вы можете найти код для этого раздела в notebooks/vectorize_data.ipynb .
Как обычно, начинаем с импорта необходимых библиотек:
import json import numpy as np import pandas as pd import torch from qdrant_client import QdrantClient from qdrant_client.http import models from sentence_transformers import SentenceTransformer from tqdm.notebook import tqdm from config import QDRANT_HOST, QDRANT_PORT, QDRANT_API_KEY, DATA, COLLECTION_NAMEЭтот код импортирует все библиотеки и переменные конфигурации, необходимые для векторизации и индексации данных. Тут стоит упомянуть несколько моментов:
- qdrant_client и qdrant_client.http позволяет взаимодействовать с клиентом Qdrant, чтобы вставлять и извлекать данные из коллекции.
- sentence_transformers позволяет генерировать векторы из текста, используя предварительно обученные модели.
Далее данные читаются следующим образом:
BOOK_FILENAME = "Marcus_Aurelius_Antoninus_-_His_Meditations_concerning_himselfe" with open(f"/processed//.json", "r") as file: meditations_json = json.load(file) rows = [] for chapter in tqdm(meditations_json["data"]): for sentence in chapter["sentences"]: rows.append( ( chapter["title"], chapter["url"], sentence, ) ) df = pd.DataFrame( data=rows, columns=["title", "url", "sentence"] ) df = df[df["sentence"].str.split().str.len() > 15]Этот код считывает ранее обработанные данные и удаляет короткие предложения. Работает это следующим образом:
- Строки с 1 по 4 читают файл JSON, созданный вами для “Размышлений”, и сохраняют его как meditations_json.
- Строки с 6 по 15 проходят через все главы книги, хранящиеся в data от meditations_json , после чего для каждой главы извлекают соответствующие данные (название главы, URL-адрес главы и предложение) и добавляют их в rows.
- Строки с 17 по 21 создают DataFrame с данными rows и удаляют предложения, содержащие менее 15 слов.
Затем вы создаете коллекцию в базе данных векторов:
# Create collection client = QdrantClient( host=QDRANT_HOST, port=QDRANT_PORT, api_key=QDRANT_API_KEY ) client.recreate_collection( collection_name=COLLECTION_NAME, vectors_config=models.VectorParams( size=384, distance=models.Distance.COSINE ), )Этот код подключается к вашему кластеру Qdrant и создает коллекцию на основе предоставленных имени и параметров. В этом случае вы устанавливаете значение size384 в зависимости от потребностей модели, которую будете использовать для векторизации предложений. Вы также устанавливаете distance, чтобы использовать косинусное расстояние, которое будет определять, как вычисляется сходство между векторами.
Следующим шагом является создание векторов (эмбеддингов) из текста. Вместо эмбеддингов на основе OpenAI вы будете использовать предварительно обученную модель из Sentence Transformers. OpenAI дороже, но не факт, что лучше.
Для этого нужно загрузить предварительно обученную модель, создать вложения из предложений DataFrame и вставляете их в созданную вами коллекцию:
model = SentenceTransformer( "msmarco-MiniLM-L-6-v3", device="cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu", ) vectors = [] batch_size = 512 batch = [] for doc in tqdm(df["sentence"].to_list()): batch.append(doc) if len(batch) >= batch_size: vectors.append(model.encode(batch)) batch = [] if len(batch) > 0: vectors.append(model.encode(batch)) batch = [] vectors = np.concatenate(vectors) book_name = meditations_json["book_title"] client.upsert( collection_name=COLLECTION_NAME, points=models.Batch( ids=[i for i in range(df.shape[0])], payloads=[ < "text": row["sentence"], "title": row["title"] + f", ", "url": row["url"], > for _, row in df.iterrows() ], vectors=[v.tolist() for v in vectors], ), )Этот код загружает модель, генерирует векторы из предложений в DataFrame и вставляет их в созданную вами коллекцию. Вот как это работает:
- Строки с 1 по 8 загружают модель преобразователя предложений msmarco-MiniLM-L-6-v3 и устанавливают правильное устройство, если у вас есть доступный графический процессор.
- Строки с 10 по 23 генерируют массив векторов, используя загруженную вами модель. Каждый вектор представляет собой числовое представление предложений из DataFrame.
- Строки с 29 по 43 вставляют векторы и дополнительные данные (фактическое предложение, название книги и главы и URL-адрес) в коллекцию базы данных векторов.
Создание сервера с FastAPI
Далее нужно создать приложение FastAPI, которое позволит пользователю взаимодействовать с векторной базой данных и ChatGPT. Код для этого раздела находится в формате main.py .
Начинаем с импорта необходимых зависимостей, настройки клиента Qdrant и загрузки модели:
import openai from fastapi import FastAPI from qdrant_client import QdrantClient from sentence_transformers import SentenceTransformer from config import ( COLLECTION_NAME, OPENAI_API_KEY, QDRANT_API_KEY, QDRANT_HOST, QDRANT_PORT, ) openai.api_key = OPENAI_API_KEY qdrant_client = QdrantClient( host=QDRANT_HOST, port=QDRANT_PORT, api_key=QDRANT_API_KEY, ) retrieval_model = SentenceTransformer("msmarco-MiniLM-L-6-v3") app = FastAPI()Этот код импортирует библиотеки и параметры конфигурации, инициализирует клиент Qdrant и загружает модель в память (ту, которую использовали для векторизации предложений). Вы загружаете свою модель глобально, иначе придётся загружать её каждый раз, когда кто-то задаёт вопрос. Это сильно замедлит запросы.
Затем вы определяете функцию, которая поможет при создании подсказок для ChatGPT, по которым он будет генерировать последовательный ответ на основе наиболее подходящих отрывков из «Размышлений»:
def build_prompt(question: str, references: list) -> tuple[str, str]: prompt = f""" Ты Марк Аврелий, римский император. Ты даёшь совет другу, который задал тебе следующий вопрос: '' Для ответа ты выбрал наиболее подходящие высказывания из твоих заметок. Укажи их в своём ответе. References: """.strip() references_text = "" for i, reference in enumerate(references, start=1): text = reference.payload["text"].strip() references_text += f"\n[]: " prompt += ( references_text + "\nHow to cite a reference: This is a citation [1]. This one too [3]. And this is sentence with many citations [2][3].\nAnswer:" ) return prompt, references_textЭтот код включает подсказку для ChatGPT, которая заставляет его «имитировать» Марка Аврелия, отвечающего на заданный пользователем вопрос, со списком ссылок, ранее полученных из векторной базы данных. Программа возвращает сгенерированный ответ и список ссылок.
Затем вы создаете две конечные точки:
@app.get("/") def read_root(): return < "message": "Make a post request to /ask to ask a question about Meditations by Marcus Aurelius" >@app.post("/ask") def ask(question: str): similar_docs = qdrant_client.search( collection_name=COLLECTION_NAME, query_vector=retrieval_model.encode(question), limit=3, append_payload=True, ) prompt, references = build_prompt(question, similar_docs) response = openai.ChatCompletion.create( model="gpt-3.5-turbo", messages=[ , ], max_tokens=250, temperature=0.2, ) return
Это две конечные точки, которые вы будете использовать в своем приложении. Вот что делает каждая строка:
- Строки с 1 по 5 устанавливают конечную точку, которая принимает запросы GET на «/». Она возвращает ответ в формате JSON с ключом сообщения, где пользователю предлагается использовать конечную точку «/ask».
- Строки с 8 по 17 определяют конечную точку, которая принимает запросы POST на «/ask» с одним параметром question типа string. Как только пользователь отправит запрос, вы векторизуете вопрос, используя модель, которую вы загрузили ранее, затем получаете 3 наиболее похожих документа из вашей векторной базы данных.
- Строки с 19 по 32 объединяют документы, которые вы получили из векторной базы данных, с вашей подсказкой и делают запрос к API ChatGPT. Вы устанавливаете max_tokens=250 , чтобы ответы были короткими, и устанавливаете temperature=0.2 , чтобы модель не несла отсебятину. Наконец, вы извлекаете ответ из ответа API ChatGPT и возвращаете его пользователю вместе со ссылками.
Если вы хотите протестировать его локально, введите следующую команду в терминал (внутри виртуальной среды проекта):
uvicorn main:app --reloadВ браузере перейдите к localhost:8000/docs, чтобы проверить конечную точку /ask:

Хороший ответ будет выглядеть следующим образом:
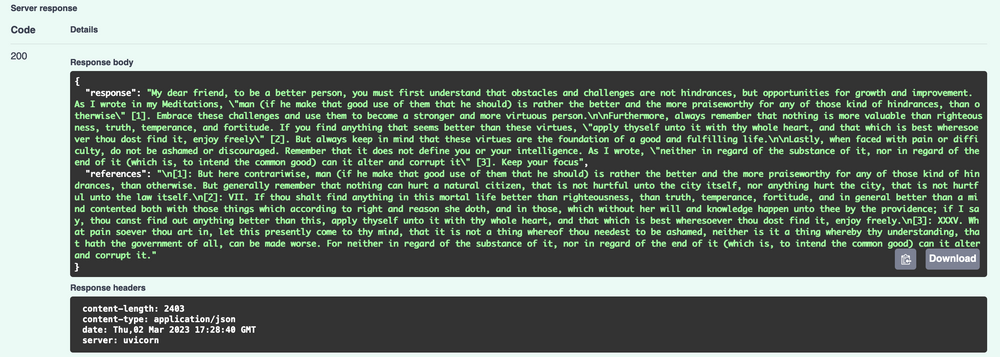
Вот и все! У вас есть рабочая версия поисковой системы с искусственным интеллектом.
Существует множество различных способов развёртывания приложения, поэтому вы можете выбрать любой подход, который вам больше нравится. Мне нравится VPS с NGINX, выступающим в качестве обратного прокси-сервера, и Gunicorn в качестве диспетчера процессов с рабочими процессами Uvicorn. Если вы хотите использовать такой же подход, посмотрите моё руководство.
И помните о следующих моментах:
- Вы должны использовать —preload, если хотите брать одну и ту же модель для всех процессов и использовать меньше оперативной памяти.
- При обслуживании некоторых типов моделей возникают проблемы с утечкой памяти. У меня получилось обойти это, установив низкие значения —max-requests и —max-requests-jitter.
Весь код для этого туториала доступен на GitHub. Спасибо за внимание!